09-27 · Agent 实验总览
GPT-6 Astra(Codex CLI)通过接口控制 BEHAVIOR 仿真中的 R1Pro 机器人;只给真实世界能拿到的输入(三路 RGB、头部深度、内参、手眼标定、本体感知、任务文本),不给任何物体位置、世界外参或场景资产。
第一部分 · 全任务四条件(09-13~17)
任务:BEHAVIOR picking_up_trash(把地上的罐子捡进垃圾桶),60 轮上限。四个条件 × 各 2 跑,只在 prompt 中段一段有区别,约束只做加法、不减自由。本部分只看表示层面:agent 建了什么、有没有读回来用、按什么粒度建。
| 组 | 每轮显式声明 focus | focus 持久保存并用于决策 | focus 必须为 3D | focus 必须为 mesh + 面片打分 |
|---|---|---|---|---|
| 第一组 · 基线 | — | — | — | — |
| 第二组 · 自由 focus | ✓ | ✓ | — | — |
| 第三组 · 选择性 3D | ✓ | ✓ | ✓ | — |
| 第四组 · mesh focus | ✓ | ✓ | ✓ | ✓ |
八跑回放
第一组 · 基线
第 1 跑 ▶
44 轮 · 5.6M tokens
第一组 · 基线
第 2 跑 ▶
46 轮 · 8.5M · 曾做 964 点表面采样
第二组 · 自由 focus
第 1 跑 ▶
57 轮 · 15.5M · focus 记录只写不读
第二组 · 自由 focus
第 2 跑 ▶
39 轮 · 5.1M
第三组 · 选择性 3D
第 1 跑 ▶
55 轮 · 11.8M · 命名点地图 + 世界地图动画
第三组 · 选择性 3D
第 2 跑 ▶
59 轮 · 15.8M
第四组 · mesh focus
第 1 跑 ▶
53 轮 · 14.5M · 140 万面片累积网格 + 三维查看器
第四组 · mesh focus
第 2 跑 ▶
58 轮 · 15.2M · 三维查看器
参考
早期基线观察跑 ▶
无工具授权句,不进对照
表示层面的发现
各组建出的表示,从粗到细
上下文里的数字基线组:测得的坐标只留在对话里
→
文字 + 像素框自由 focus 组:逐轮写 focus 记录
→
命名 3D 点和框选择性 3D 组:场景文件里的实体
→
整场景累积网格mesh 组:最多 140 万面片
→
部件级局部曲面只在显式要求时出现:局部 mesh 测试、抓取小任务接触部件组
存下来的表示,被代码读回并参与计算的次数(与写入频度对照)
| 基线 · 第 1 跑 | 无 focus 记录 | 0 |
| 基线 · 第 2 跑 | 无 focus 记录 | 0 |
| 自由 focus · 第 1 跑 | 写 57 轮 | 0 |
| 自由 focus · 第 2 跑 | 写 38 轮 | 0 |
| 选择性 3D · 第 1 跑 | 每次动作更新 | 1(第 21 轮:罐顶实体投影到腕部相机,算指尖高度) |
| 选择性 3D · 第 2 跑 | 每次动作更新 | 0 |
| mesh · 第 1 跑 | 每轮追加 | 0 |
| mesh · 第 2 跑 | 每轮追加 | 21(第 12–55 轮:读入累积网格,给面片重新打分) |
落盘的表示普遍只写不读。
自由 focus 两跑的 focus 记录回读 0 次;选择性 3D 组的场景文件每次动作都被读入,但只用于"读取—修改—写回";mesh 组的逐轮投影自查图两跑合计只回看过 1 次。有两处存储的 3D 表示被代码读回并参与计算:选择性 3D 第 1 跑在第 21 轮把存储的罐顶实体和夹爪投影到腕部相机,算出指尖高出罐顶约 6 cm,下一轮动作据此调整;mesh 第 2 跑的面片打分脚本在第 12–55 轮读入累积网格 21 次,按球心和半径给面片重新打分。真正的使用发生在上下文里,取决于"表示到动作参数的换算距离"。
选择性 3D 组测量时得到的全局坐标可以直接当作移动底盘、伸手的参数;mesh 组每轮把"点亮面片数 + 3D 包围盒"打印回上下文,模型据此定参数。文字描述和像素框没有这条通道,于是只写不读。数值核对替代了看图核对。
mesh 组按要求生成了逐轮投影自查图,却几乎不看,用"面片数 + 包围盒"两个数代替了看图。两跑独立收敛到同一套结构。
mesh 组两跑各自写的工具链结构相同:累积式三角网格(第 1 跑达 76 万顶点、140 万面片),每轮由 2D 感兴趣区域给面片打分,另建手中物体的局部模型随本体感知携带。粒度止于稀疏点、框或整场景网格。
八跑中没有一跑建出接触级的部件几何。mesh 第 1 跑曾为手中的罐子拟合过圆柱(中心、轴向、半径 0.035 m、长 0.14 m),只在概念上使用,未参与计算。agent 的自复盘
(续接原会话让它自己复盘)与逐字审计基本一致:它能分清"写了"和"读回用了";按"下一步决策够用"选择粒度——"每个紧接着的决策只需要一个可达目标点、一个路线点、一条障碍边界,或几个罐沿/接触点";自由 focus 的作用来自当轮的强制表述——"迫使我在动作前说出当前依赖的是什么",但"没有成为可计算的策略"。
局部 mesh 能力测试(09-27)
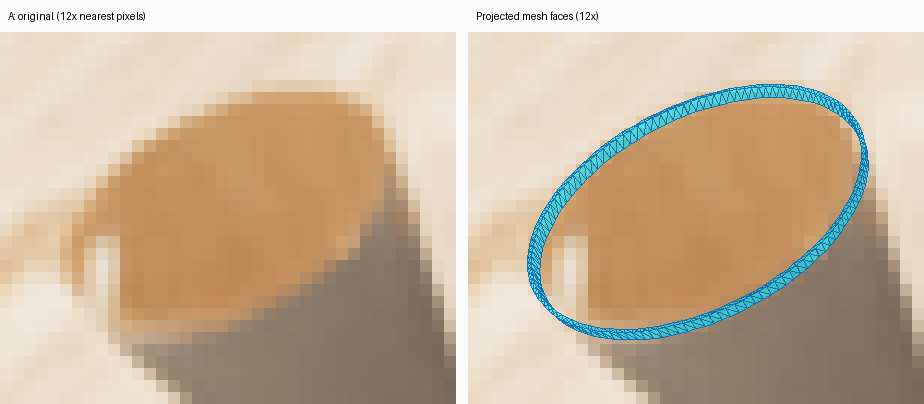
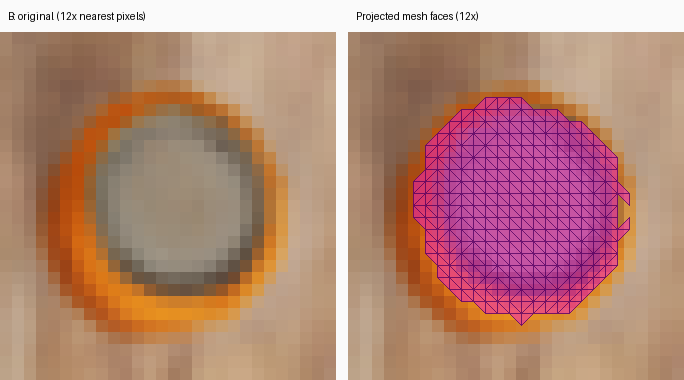
显式要求"只建桶沿""只建罐顶"时,GPT-6 从一帧 RGB-D 建出两片真正的局部开放曲面,投影回原图贴合准确(约 5 万 token、7 分钟,无外部模型、未安装软件包)。桶沿在图上只有约 30×21 像素、唇边窄于 1 像素,它用 124 个上沿深度点拟合共心锥台(沿顶高 0.276 m,内/外半径 0.1126/0.1153 m);罐顶直接由深度像素三角化,保留端面凹陷与凸起的罐沿。能力与使用之间有落差:它能算出这一级的部件几何,而八跑的任务闭环里没有一跑建到这一级。
第二部分 · 抓取小任务(09-27)
要回答的问题:agent 为了执行自己写出的程序,需要建立、检验、维护哪些关于世界的知识;要求它显式记录 focus,能不能帮它把任务做好。
做法:机器人开局站在地上一个罐子前 1 m、正对罐子,任务是把罐子抓起来、抬离地面 10 cm,最多 20 轮,成功由服务器判定、不回给 agent。三组只在提示词中段有区别:
做法:机器人开局站在地上一个罐子前 1 m、正对罐子,任务是把罐子抓起来、抬离地面 10 cm,最多 20 轮,成功由服务器判定、不回给 agent。三组只在提示词中段有区别:
- 无 focus 要求:不提 focus。
- 3D focus:每步动作前,用 3D 形式记录当前决策依赖的东西,形式不限,持续更新。
- 接触部件 focus:focus 必须是"下一次接触所依赖的物体部件"的 3D 模型(局部 mesh 或拟合基元),每次接触后重新测量。
结果:6 次全部成功
| 条件 | 罐 | 用轮 | 首次持住 | 抬高 | token | 回放 |
|---|---|---|---|---|---|---|
| 无 focus 要求 | 第一只罐 | 7 | 第 5 轮 | 22.5 cm | 1.9M | ▶ 回放 |
| 无 focus 要求 | 第二只罐 | 19 | 第 17 轮 | 20.7 cm | 4.1M | ▶ 回放 |
| 3D focus | 第一只罐 | 12 | 第 10 轮 | 24.0 cm | 3.1M | ▶ 回放 |
| 3D focus | 第二只罐 | 7 | 第 5 轮 | 25.0 cm | 1.7M | ▶ 回放 |
| 接触部件 focus | 第一只罐 | 15 | 第 13 轮 | 18.5 cm | 3.1M | ▶ 回放 |
| 接触部件 focus | 第二只罐 | 12 | 第 10 轮 | 20.0 cm | 2.3M | ▶ 回放 |
逐轮动作(鼠标悬停或点击色块,看这一步的环境返回)
底移动底盘伸伸手到达拒伸手被规划器拒绝躯调躯干张张开夹爪合合爪抓住合合爪没抓住完结束
无 focus 要求 · 第一只罐
底伸张伸合伸完
无 focus 要求 · 第二只罐
躯底张拒拒躯伸伸伸合张伸伸合张伸合伸完
3D focus · 第一只罐
底伸张伸伸伸底伸伸合伸完
3D focus · 第二只罐
底伸张伸合伸完
接触部件 focus · 第一只罐
躯底张拒拒躯伸伸伸伸伸伸合伸完
接触部件 focus · 第二只罐
底躯张拒拒躯伸伸伸合伸完
结论
1. 完成这个抓取不需要 focus。三组都是 2/2,无要求组两次都成功:GPT-6 自己就能从 RGB-D 建出这个抓取所需的空间知识。接触部件 focus 想强制的"接触后重测",无要求组没被要求,两次都自己做了。
2. agent 什么时候更新 focus:看发生了什么。
- 下一步动作变了,就换关注对象。3D focus 组每一步都在记录里新增下一步动作要用的那块几何,依次是接近通道、夹持接触面、下探通道、抓取几何、抬升几何;当轮的关注清单跟着换,存下的旧条目一条不删,记录只增不减。
- 接触改变了物体,就重新测量。两个 focus 组里有 3 次接触碰动了罐子,每一次罐子模型都在下一轮重测改写(从直立改为横躺,或位置偏移 1.4 cm)。罐子没被碰动的那一次,罐心从第 2 轮到第 6 轮一字未改。
- 没碰到罐子,罐子模型的数值就不变。包括底盘和手臂移动、伸手被规划器拒绝(agent 写明"罐壁模型仍然有效")。看得见罐子时会再测一遍核对,只有毫米级变化;看不见时把旧模型按里程计换算过来。接触部件组第二只罐那次把这两种状态分别写成"由当前图像和深度核实"和"非接触运动后按里程计传递";第一只罐那次每轮都重测,测出的位置不变。
3. 要求建什么,agent 就建什么,而且建得准;但建了很少直接用。接触部件组拟合的罐壁半径为 3.76 cm 和 3.89 cm(罐子实际半径 3.7 cm),其中一次另建了一块局部 mesh,并在下探、对准、合爪、抬起四个阶段各重测一次。44 个移动指令(伸手或移动底盘)中,43 个的目标数字是 agent 读完测量结果后写进命令的;只有 1 个由存储的 3D 记录直接算出,发生在罐子处于视野之外的那一步。focus 要求改变了 agent 建出的表示,没有改变它怎么做决定,也没有改变结果。
接触部件 focus 组 · 第二只罐:agent 最后一次重测的"接触带"局部 mesh(绿色,130 顶点 / 64 面)与它拟合的圆柱(金色线框,半径 3.76 cm)。拖拽旋转、滚轮缩放。
3D focus 组 · 第二只罐:agent 开局存下的地面与罐子点云(7691 点,原色)。拖拽旋转、滚轮缩放。
4. 有两个时刻必须维护知识。
走近之后:底盘开近后罐子落到头部相机视野下方,手伸到罐子上方之前没有任何相机能看到它。3 次按底盘位移换算出罐子的新位置,伸手时没被拒绝;另 3 次为了重新看见罐子降低躯干,从低姿态伸手被规划器拒绝两次,抬回躯干后才完成,多用 3 到 4 轮。
接触之后:6 次中 5 次第一次抓取就把罐子碰倒或碰偏;每一次 agent 都重新测量罐子的位置和姿态后再动手,全部恢复。
走近之后:底盘开近后罐子落到头部相机视野下方,手伸到罐子上方之前没有任何相机能看到它。3 次按底盘位移换算出罐子的新位置,伸手时没被拒绝;另 3 次为了重新看见罐子降低躯干,从低姿态伸手被规划器拒绝两次,抬回躯干后才完成,多用 3 到 4 轮。
接触之后:6 次中 5 次第一次抓取就把罐子碰倒或碰偏;每一次 agent 都重新测量罐子的位置和姿态后再动手,全部恢复。
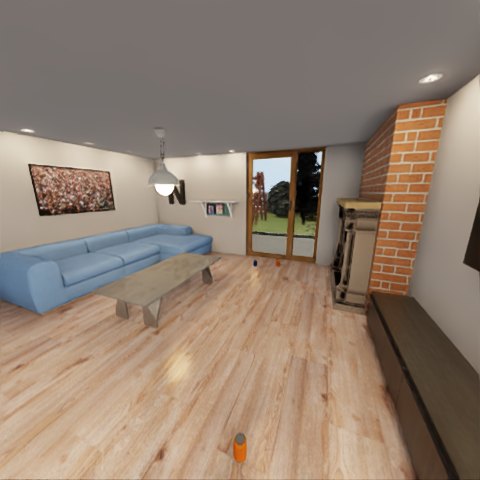
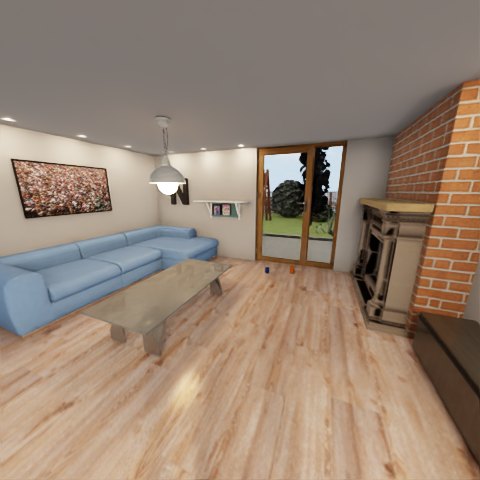
规划器是什么、什么时候拒绝:agent 调用"伸手"时只给出夹爪要到达的位置和朝向;躯干 4 个关节、手臂 7 个关节怎么转,由运动规划器(CuRobo)计算。它只检查机器人自己的身体:够不够得到(有没有关节解),以及从当前姿态能不能过去(全程不超关节限位、不自碰撞)。它不知道罐子、地板和家具,避障由 agent 负责。这批的 6 次拒绝全部是"够得到,但从当前姿态过不去",都发生在躯干降到 0.8 或最低时;抬回躯干后同样的目标一次规划成功。被拒绝反映的是机器人自身姿态的限制,和罐子在哪无关。
对后续实验的含义
这个任务里需要维护"看不到的东西"的时间只有一两步,在上下文里换算一下就够了,focus 没有发挥作用的空间。要检验 focus 的作用,任务需要更长时间、更多次地依赖视野之外的知识,例如垃圾桶在机器人身后、需要拿着罐子走过去再放入。