第三节 · 热图作为重建监督(task-0003,开环)
radio 的判决(第二节)说明输入侧注入在该任务上没有梯度压力。本节换两个东西:任务换成需要视觉消歧的 task-0003;热图不再作输入,改作训练期的重建监督信号(ReconVLA 思路)——测试期完全不需要热图。问题变为:这份监督能否让骨干把注意力聚到该操作的物体上,从而降低动作误差。
① 模型架构(加了重建头 + 转全量微调 → 画架构图)
与第一、二节(轻量法)的两个不同:改全量微调(重建损失的梯度要能改到视觉骨干才有意义);热图从输入侧挪到监督侧。
重建目标怎么构造(训练管线实际消费的真实数据)
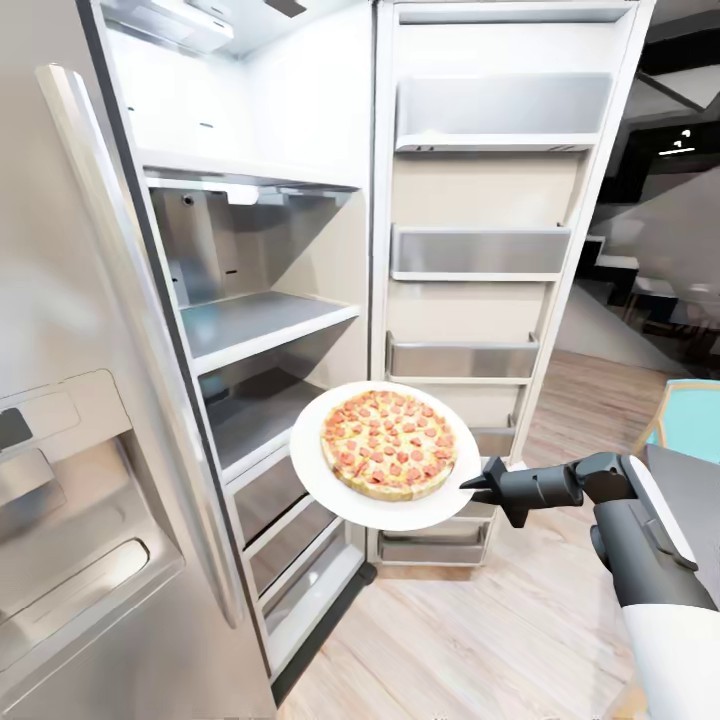
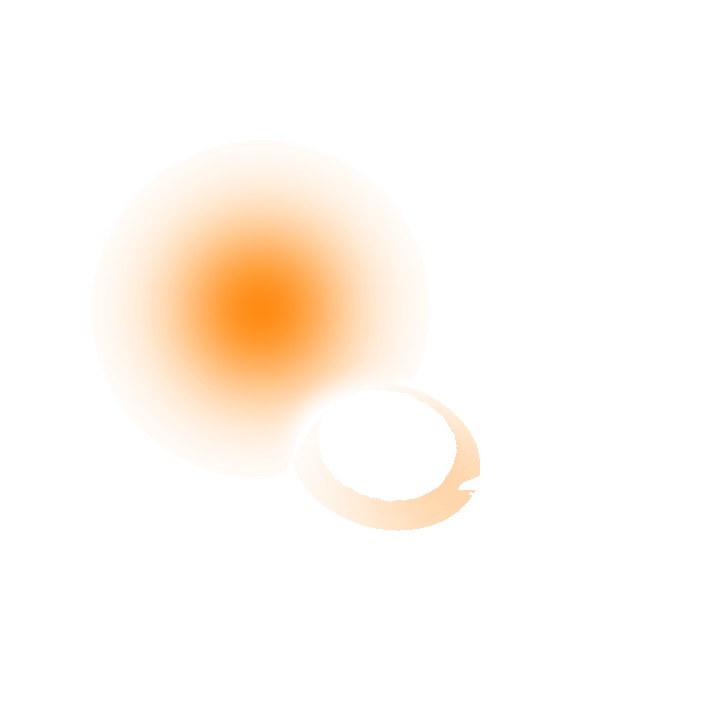
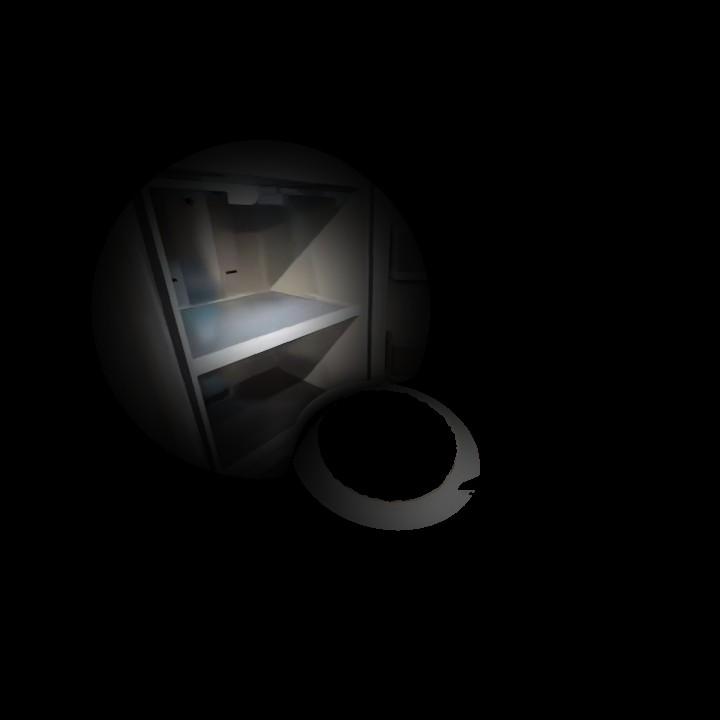
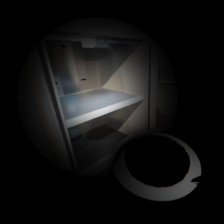
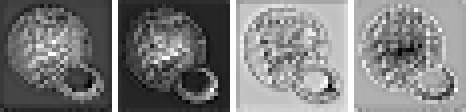
task-0003 训练集 episode_00030040 第 2850 帧:机器人正把餐盘放进冰箱,热图压在放置目的地与盘缘。四联全部由训练脚本同款数学从原始数据渲出,latent 直接读自训练消费的预编码文件。
② 训练数据与步数
| 项 | 值 |
|---|---|
| 任务 | BEHAVIOR-1K cleaning_up_plates_and_food(task-0003,收拾餐盘食物:把餐盘、食物从桌面收进冰箱/置物架) |
| 为什么换它 | 不同 demo 收拾的对象与去处不同 → 光靠关节状态记不住"这次该拿哪个",视觉消歧成为拟合必需(radio 恰好相反) |
| 数据 | 200 集官方演示:train 182 / test 15(切分种子 3)/ 3 集无 GT 排除 |
| 训练 | 2 模型(基线 / 加重建,唯一差别 = 重建损失 0.25)× 2 种子(42/43),各全量微调 6000 步,batch 32 |
“不同 demo 收不同对象”长什么样(真实训练帧 + GT 热图叠加)
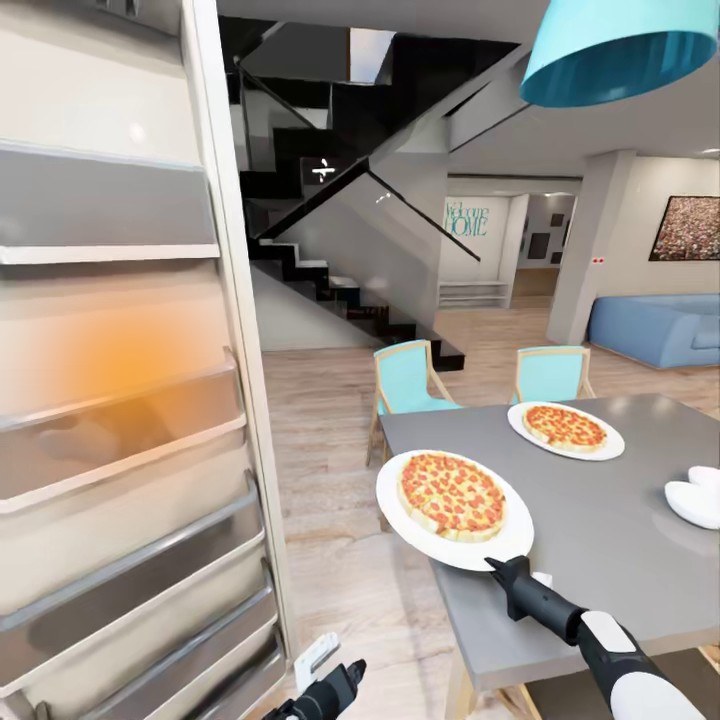
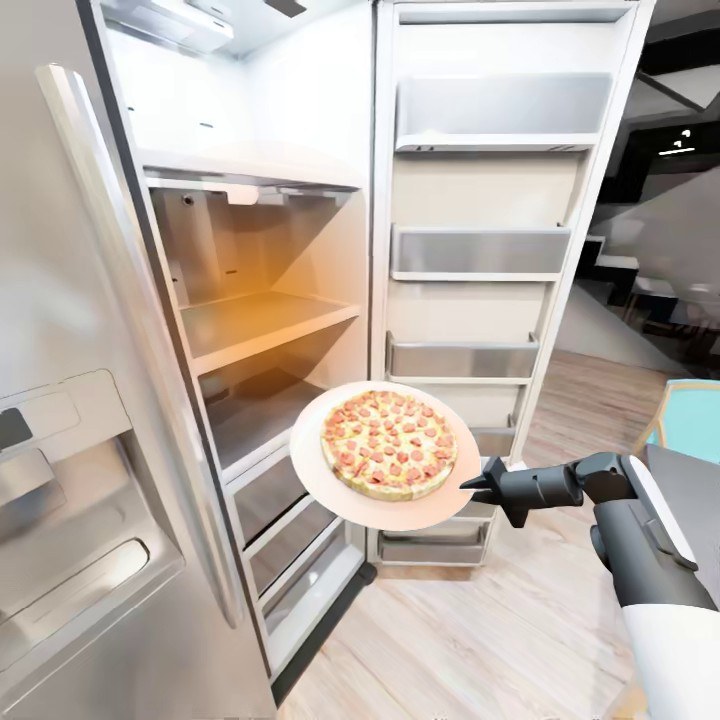
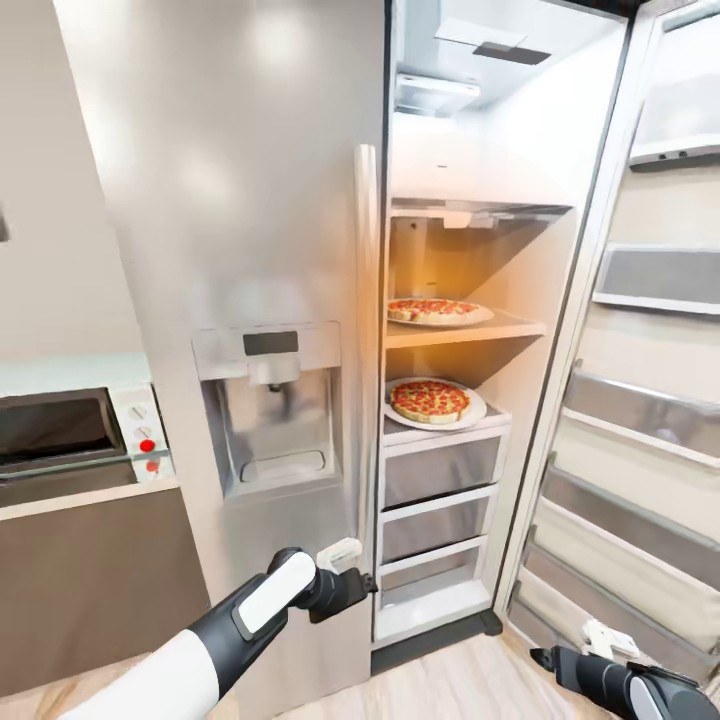
三集在同一场景但收拾对象、顺序、去处各不相同——模型必须看画面才能知道当下该操作什么。
③ 可训与冻结参数
| 组件 | 规模 | |
|---|---|---|
| 可训 🔥 | π0.5 全模型(SigLIP 视觉 + Gemma 语言 + 动作专家列)+ 重建头(训练结束丢弃) | 3.3B + 约 8M |
| 冻结 ❄ | SD-VAE(只用来把监督目标编码成 latent,不在模型里) | 84M |
架构图中已标 🔥/❄。基线与加重建两组的可训范围完全相同,唯一差别是损失里多一项重建损失。
④ 评测方式
开环,与第一节同口径:15 留出集逐帧预测 32 步动作块,与真值逐维 L1、按身体部位分组;基线与加重建看同帧同噪声(配对,n=15216);主要终点 = subgoal 交接帧。测试期不提供热图(本方法测试期本来就不需要)。
⑤ 结果与结论
悬停可看精确数值。* = 95% 区间不含零。判读要点:把每格数据点与它背后的灰色噪声带比——8 格全部落在噪声带内或边缘,且过显著线的格子方向混合(底盘变好、双臂夹爪变差)。
种子噪声尺(判定"无信号"的依据)
| 对 | 层 | 底盘 | 躯干 | 双臂 | 夹爪 |
|---|---|---|---|---|---|
| 基线 种子2−种子1 | subgoal 交接帧 | −2.33±2.27 | −10.81±6.46 | +6.94±2.25 | +9.62±4.33 |
| 加重建 种子2−种子1 | subgoal 交接帧 | +1.87±2.08 | −2.19±7.04 | +4.35±2.04 | +4.96±14.91 |
| 基线 种子2−种子1 | 其余帧 | −1.88±0.75 | −5.71±2.42 | +0.11±0.89 | −8.58±4.88 |
| 加重建 种子2−种子1 | 其余帧 | +0.78±0.71 | −0.84±2.53 | −1.52±0.93 | −0.68±4.91 |
同一方法只换随机种子,差异就有 ±0.1–10.8%;组间差(±0.3–4.8%)没有超出这个量级。单格例子:底盘交接帧在种子 1 上 −4.64*,在种子 2 上只有 −0.53;躯干在种子 2 上 +8.49*,种子 1 上 −1.07——方向都会翻。
结论:重建监督版与基线的组间差落在种子噪声之内,方向混合、跨种子不稳——无信号(既没有变好,也没有变坏)。ReconVLA 原配方还有一个本轮缺失的成分:大规模重建预训练。第四节补上它。